用 Pandas 做 RFM 用户分层:从订单到客户分类
适合掌握 Python 基础的读者。使用公开的模拟订单完成清洗、RFM 评分与分层,提供数据、完整脚本和结果图。
继续上次小节 →数据分析线 · 线路目录
本页导读
这篇文章要完成什么
用一份 完全模拟的订单数据,按最近购买时间、购买次数和金额给用户分层。本例只说明方法,不代表真实客户,也不用于推断业务效果。
前置知识:Python 基础、Pandas 的读取与分组操作。这里每行是一笔订单,金额单位一致;真实订单若含多行商品,应先按订单编号汇总,不能直接把商品行数当购买次数。
下载与运行
把 sales.csv、rfm.py 和 requirements.txt 保存到同一文件夹。使用 Python 3.11–3.13(本例在 3.12 验证),在该文件夹打开终端:
python -m venv .venv
# macOS / Linux
source .venv/bin/activate
# Windows PowerShell 使用 .venv\Scripts\Activate.ps1
python -m pip install -r requirements.txt
python rfm.py
脚本按自身所在目录寻找数据,不依赖终端的工作目录。它生成 rfm_result.csv 和 segments.png,不需要图形界面。
1. 先明确 R、F、M
- R(Recency):距离基准日最近一次购买的天数,越小越活跃。
- F(Frequency):有效订单数,本例每行是一单。
- M(Monetary):有效订单金额总和。
基准日期固定为 2024-05-01。示例删除必需字段缺失、金额不大于 1、基准日当天及之后的记录。原始数据 10 行,保留 8 笔订单,得到 5 位用户;被排除的 X、Y 用于演示清洗。
2. 分组计算
sales.groupby("USERID").agg(
    last_order=("ORDERDATE", "max"),
    frequency=("ORDERDATE", "size"),
    monetary=("AMOUNTINFO", "sum"),
)
用基准日减去 last_order 得到天数。例如用户 A 最近在 4 月 30 日下单,所以 R 为 1;两笔订单合计 500,因此 F 为 2、M 为 500。
3. 评分与边界
本例使用固定教学阈值,不使用五分位法。pd.cut 按指定边界分箱;若目标是按样本分位数分组,应另行选择适合数据分布的方法,并处理重复边界。
| 维度 | 从左到右的区间 | 对应分数 |
|---|---|---|
| R | [0,7]、(7,30]、(30,60]、(60,90]、(90,+∞) | 5、4、3、2、1 |
| F | (0,1]、(1,2]、(2,3]、(3,4]、(4,+∞) | 1、2、3、4、5 |
| M | (0,50]、(50,100]、(100,200]、(200,400]、(400,+∞) | 1、2、3、4、5 |
总分 = R 分数 × 0.2 + F 分数 × 0.2 + M 分数 × 0.6。权重和阈值均为教学选择,不是通用业务标准。最近购买对应较高 R 分数,不要与较小的原始 R 天数混淆。
分层为 Low:[0,2];Medium:(2,4];High:(4,5]。因此恰好 2 分归 Low、恰好 4 分归 Medium。
4. 完整代码
下面与下载脚本保持一致:
"""Synthetic RFM exercise. Run with Python 3.11-3.13; files resolve beside this script."""
from pathlib import Path
import pandas as pd
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

BASE = Path(__file__).resolve().parent
DEADLINE = pd.Timestamp("2024-05-01")
raw = pd.read_csv(BASE / "sales.csv", parse_dates=["ORDERDATE"])
sales = raw.dropna(subset=["USERID", "ORDERDATE", "AMOUNTINFO"])
sales = sales[(sales["AMOUNTINFO"] > 1) & (sales["ORDERDATE"] < DEADLINE)]
rfm = sales.groupby("USERID").agg(
    last_order=("ORDERDATE", "max"),
    frequency=("ORDERDATE", "size"),
    monetary=("AMOUNTINFO", "sum"),
)
rfm["recency"] = (DEADLINE - rfm.pop("last_order")).dt.days
# Fixed teaching thresholds, NOT quantiles. Recent purchases receive higher scores.
rfm["r_score"] = pd.cut(rfm.recency, [0, 7, 30, 60, 90, float("inf")], labels=[5, 4, 3, 2, 1], include_lowest=True).astype(int)
rfm["f_score"] = pd.cut(rfm.frequency, [0, 1, 2, 3, 4, float("inf")], labels=[1, 2, 3, 4, 5]).astype(int)
rfm["m_score"] = pd.cut(rfm.monetary, [0, 50, 100, 200, 400, float("inf")], labels=[1, 2, 3, 4, 5]).astype(int)
rfm["score"] = (rfm.r_score * 0.2 + rfm.f_score * 0.2 + rfm.m_score * 0.6).round(2)
# pd.cut uses right-closed intervals: [0, 2], (2, 4], (4, 5].
rfm["segment"] = pd.cut(rfm.score, [0, 2, 4, 5], labels=["Low", "Medium", "High"], include_lowest=True)
rfm.to_csv(BASE / "rfm_result.csv")
counts = rfm.segment.value_counts().reindex(["Low", "Medium", "High"], fill_value=0)
fig, ax = plt.subplots(figsize=(6, 4), layout="constrained")
ax.bar(counts.index, counts.values, color=["#78909c", "#26a69a", "#5c6bc0"])
ax.set(title="Customer segments (synthetic data)", xlabel="Segment", ylabel="Customers", ylim=(0, 3))
ax.set_yticks([0, 1, 2, 3])
fig.savefig(BASE / "segments.png", dpi=160)
plt.close(fig)
print(rfm[["recency", "frequency", "monetary", "score", "segment"]].to_string())
5. 核对结果
| 用户 | R 天数 | F 次数 | M 金额 | 总分 | 分层 |
|---|---|---|---|---|---|
| A | 1 | 2 | 500 | 4.4 | High |
| B | 11 | 1 | 100 | 2.2 | Medium |
| C | 61 | 1 | 20 | 1.2 | Low |
| D | 4 | 2 | 200 | 3.2 | Medium |
| E | 89 | 2 | 15 | 1.4 | Low |
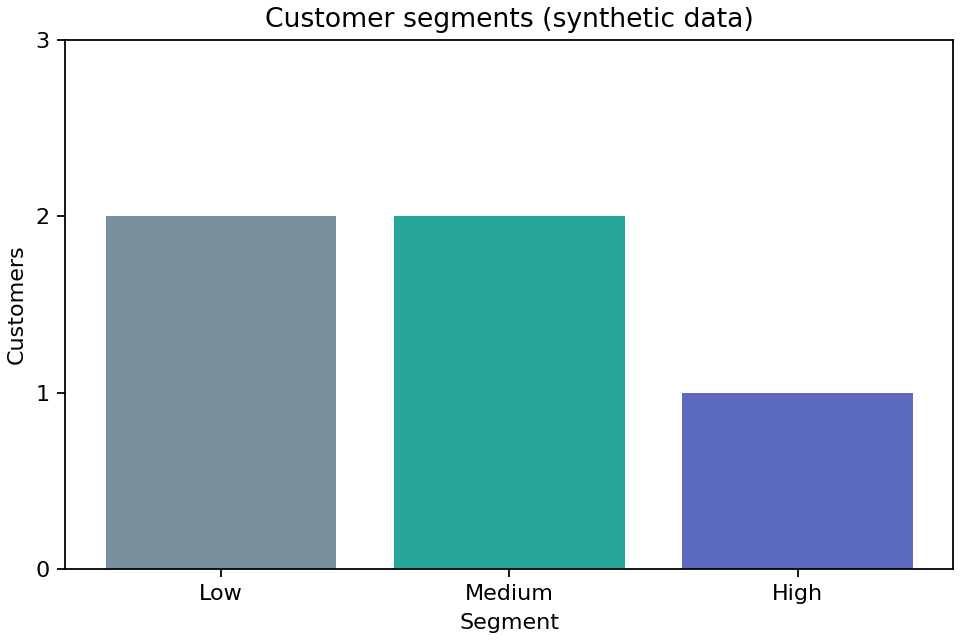
预期人数:Low 2、Medium 2、High 1。可对照 结果 CSV。
6. 换成自己的数据前
先确定分析时间窗、订单口径、退款处理方式及金额币种。本例没有去重订单 ID,也没有处理跨币种、退款和用户生命周期。不要直接把这组阈值用于真实客户决策;应结合分布和业务目标解释分层,并验证后续效果。